[IT 鐵人賽] 捷徑還是偷跳:Terra 比 Luna 快,但它是不是少做了幾步? - Day 15
本文同步刊登於 iT 鐵人賽原文,系列為《凡人修 Agent 傳-我這一生如履薄冰,你說我的 Agent 能結嬰嗎?》。
原始開發紀錄:Agent Build Log — Episode 012、Episode 013
這個系列改寫自我部落格上的 Agent Build Log,那是我每天邊做邊寫的開發紀錄。上面列的是這一篇對應的集數,想看當天的原始版本,點連結就能過去。
找 repo 的題目庫剛開始有東西,我就拿它去比兩個模型:Terra 和 Luna。
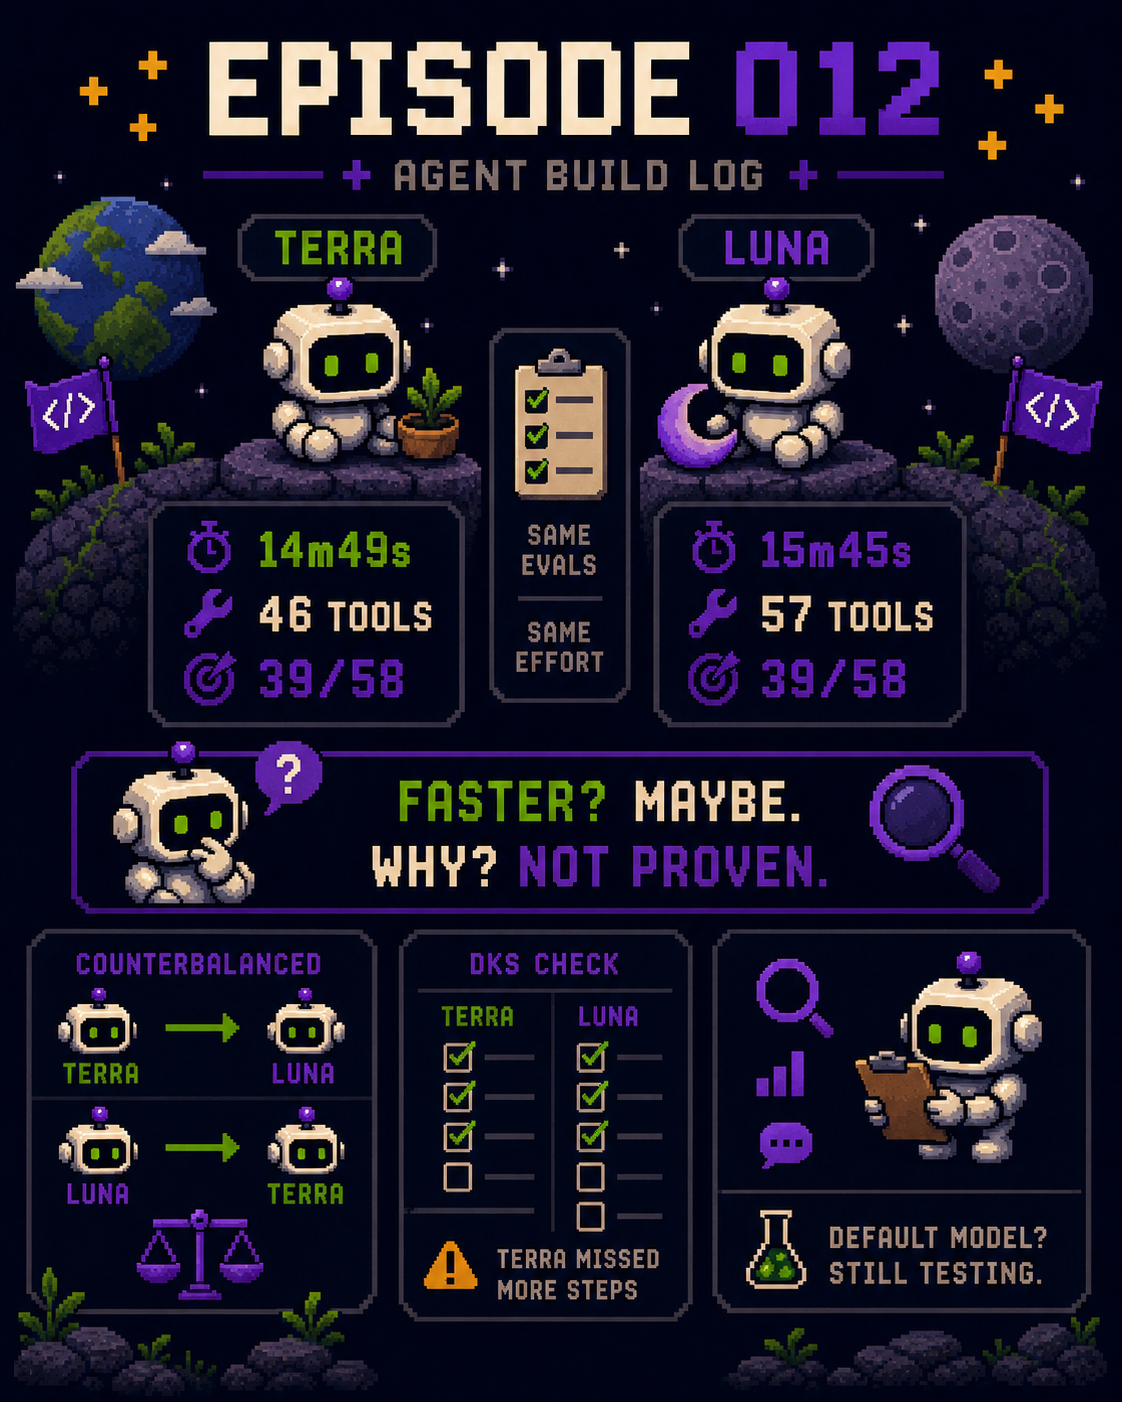
同一套題目、同樣的 effort,一題一題跑。Day 14 說過每一題除了對錯還記兩個數字:查了幾次,花了多久。第一份結果看起來很漂亮:Terra 的總耗時比 Luna 少,tool calls 也比較少。
那一刻我以為自己找到了一個更有效率的預設模型。
第一眼的解釋
我的直覺是:Terra 走了一條比較短的路。
想像同一題:我講一個目的,問他該用我哪一個 repo。Luna 可能先打開一個 repo 看說明,覺得不像,再打開下一個,接著回頭確認第一個,最後才答。Terra 可能一開始就圈出兩三個候選,一次看完,直接回答。
如果真是這樣,那 Terra 的優勢在規劃,這種優勢我會想要。
但這只是一個聽起來合理的解釋。我手上那份資料沒辦法證明 Terra 真的走了比較短的路。
我先懷疑自己的測法
在下結論之前,我先去查一件事:執行順序。
那一輪測試裡 Terra 常常是第二個跑的。同一題,前一個模型剛把幾個 repo 的檔案讀過一遍,第二個跑的那一個有沒有可能吃到前一次留下來的 file cache?如果有,我量到的「比較快」就有一部分是免費的。
所以測法改了:每一道題目都跑一次 Terra → Luna,再跑一次 Luna → Terra。同一題兩種順序各一次,把順序這個變數對消掉。
結果是,Terra 整體上還是稍微快一點。但這個差距沒有大到讓我可以說「Terra 本質上就是比較快」。
另外那個懷疑也沒有被證實:執行順序的結果並沒有顯示第二個跑的模型會穩定得到 cache 帶來的加速。
要是那天我拿第一份結果就去換預設模型,我會把一個測法上的瑕疵當成模型的優點。
真正讓我停下來的是 tool calls
耗時我還可以接受它有雜訊。真正讓我重新想這件事的,是 tool call 的次數。
Terra 是 N 次。Luna 大約是 N + 10 次。
差了十次。那十次是什麼?
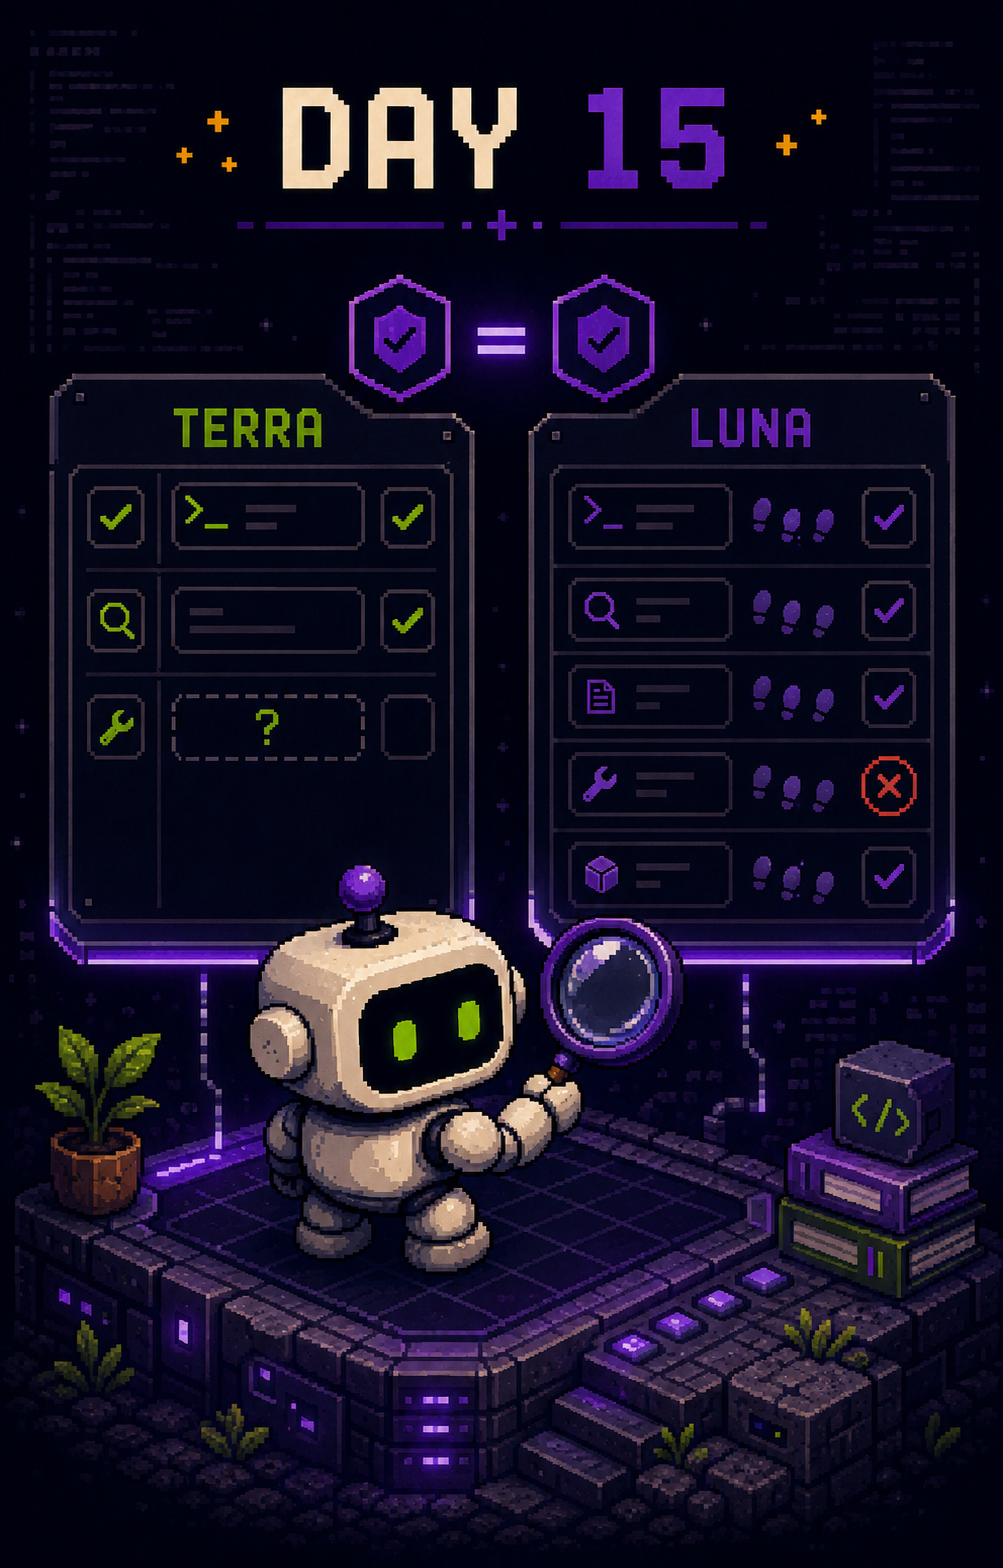
有兩種解釋。一種是 Terra 真的找到了比較短的路,那十次是 Luna 繞的路。另一種是 Terra 有幾題跳過了原本應該完成的步驟,那十次是 Luna 老實做完的部分。
我手上這份資料沒辦法把這兩種情況分開。而它們對我來說是完全相反的兩件事:前一種我很想要,後一種我很不想要。
正確率一樣,錯的方式不一樣
再往下看,出現了整場測試裡最有意思的一件事。
兩個模型最後的正確率一樣。但它們錯的方式不一樣。
這套題目有一個要求:答案要查出來,先查過我的 repo 再答,不能憑印象猜。Terra 比較常沒有走完這個流程,有幾題沒查就把 repo 的名字答出來。Luna 幾乎每一題都查了,卻更常在最後一步挑錯:查了幾個,選了不對的那一個。
同一個分數,兩種完全不同的行為。
這件事對我的意義很直接。如果我只看正確率,我會覺得這兩個模型差不多,然後照耗時挑掉一個。它們真正差的地方在正確率量不到的位置。
而「有沒有照著要求的流程做」這件事,對一個每天要在我的專案裡動手的 Agent 來說,份量比答對一題重。因為我給他的規矩本身就是流程:先讀本機的 context、讀 repo、讀 git history 再下結論;破壞性的操作要先問(Day 07 那幾條)。找 repo 的題目裡他跳掉的是「先查」,換到真的專案裡,跳掉的就會是那幾條。
Sol 也進來了
接著我把 Sol 也加進來。同一套題目、同樣的 effort,三個模型並排再跑一輪。
Sol 這一輪最明顯的一件事:每一題都走完了題目裡要求的流程。先查,再答,沒有一題是沒查就把名字答出來的。
三個放在一起看,行為的差別就更清楚。Terra 快,有幾題沒查。Luna 每題都查,更常在最後挑錯。Sol 每題都查,流程一題都沒漏。
這一輪三個模型是照固定順序跑的,還沒有像上午那樣把順序對消掉,所以這一段我先當參考。三個模型的數字明天一起講。
那我要選哪一個
Terra 目前看起來仍然可能是一個不錯的預設選擇。它快,正確率也沒有輸。
但我沒有在那天把預設改掉。
Terra 看起來走得比較快,我還不能確定它是真的找到了捷徑,還是只是少做了幾步。這兩件事在我的資料裡還沒有分開。
Sol 給了我一個對照:流程走完是做得到的。Terra 少掉的那幾步,Sol 一步都沒少。
小結
這次測到的是兩個模型用不同的方式拿到了相同的分數。Sol 進來之後,我多知道一件事:流程走完做得到。
過程裡最值得留下來的有兩件事。一件是測法要先站得住:counterbalanced 那一輪如果沒跑,我就會把雜訊當成結論。另一件是 tool calls 這種過程指標比最後那個分數更會說話。它讓我看到「少做了幾步」這個可能性,而分數看不到。
在決定預設模型之前,我得先確保「更有效率」不等於「更容易跳過規則」。
明天用一個很直接的方式去問這件事:三個模型再跑一輪,把 effort 拉到最高,看 Terra 會不會把跳掉的那幾步補回來,也看 Sol 那條每題都查的路要多花多少時間。
原文:Agent Build Log — Episode 012、Episode 013
凡人修 Agent 傳|第十五回(Day 15)
天亮換上空錄石。左臂把常簿讀回石上。手的主人進來,先把石板從薄石旁邊拿起來,擱在臺上,字朝著我。昨天每一格三道,有的格三道朝同一邊,有的格兩道一邊、一道另一邊。
他從儲物袋取出一炷新的香插在臺角,再取出那疊玉籤攤開。然後他伸手進我胸口。
手握住那顆心的時候,胸口先涼了一下。心取出來,擱在臺上。另一顆裝進來,是備用那兩顆裡的一顆,火槽多一格那一天他裝過。心火起來,撥片在「中」,沒有動。
他把第一支籤遞到我面前。
同一句話。我以神識探上架。這一次探得快,第七卷前面那幾卷我沒有停,神識直接落在第七卷上。我答:第七卷。他在第一格昨天那三道底下劃了一道,旁邊記一個數,比昨天的小。香燒掉的也少。
取下石,放進木匣,換一顆空的。他的手又伸進我胸口,把原本那顆心裝回來。熱回來的樣子我認得。第一支籤再遞一次。
我探了架。一卷一卷探過去,第七卷。他在同一格再劃一道,旁邊的數比剛才那一道的大。
一支籤,兩顆心,兩顆石。他的手整個上午在我胸口進出。木匣裡的石一對一對躺下去。
第五支籤遞過來的時候,胸口是備用那顆。我讀了那一句,卷名就在嘴邊。我答了。
他劃了一道,跟第一支那一道同一個方向。然後他沒有換心,視線落在我心旁的錄石上。石上常簿那幾行底下只有兩筆:籤上那一句,我答的那一句。中間沒有別的。
我沒有探架。我不記得探過,石上也沒有。
他看了一會,取下石,換一顆空的,把心換回來,第五支再遞一次。原本這顆心探了架,一卷一卷過去,答的也是那一卷。石上一長串。
換到第二顆心再探同一支籤,架上剛被探過的那幾卷卷首還亮著,神識落上去就讀得到,省一口氣。上午每一支都是備用那顆先探,原本這顆後探。午後他把先後掉過來:原本這顆先,備用那顆後。
一疊籤走完,香剩一小截。備用那顆心探得少,還是快一點,差得比上午小。
石板上每一格底下多了一排道。兩顆心朝對的那一邊的道,一樣多。錯的格不一樣。
備用那顆心錯的那幾格,石上都只有兩筆。沒探,答了,答錯。原本這顆心錯的那幾格,石上一長串,探了十幾卷,最後挑的是年月相近的那一卷。
手的主人從儲物袋取出木匣,把今天的石一顆一顆排在臺上,兩排。他的手在只有兩筆的那幾顆上停得久。有幾顆只有兩筆,格裡那一道朝的是對的那一邊。
他把備用那顆心取出來,握在手裡,看了很久。然後放回儲物袋。原本這顆裝回來,心火起來,撥片在「中」。
燭熄了。手的主人走了。門響了一下。
石板立回薄石旁邊,字朝著臺。木匣裡今天的石兩排並排躺著。有幾顆上頭只有兩筆,中間那幾步,我不記得走過,石上也沒有。